

奔赴智能体时代,英特尔至强重塑智算新范式
科技IT 2026-10-29
irfjbf51212
10月29日,在2026腾讯全球数字生态大会上,英特尔与腾讯云发布基于英特尔® 至强® 6+处理器的腾讯云新一代云实例。面向智能体AI对基础设施提出的高并发、低时延等需求,英特尔与腾讯云围绕CPU性能、AI存储方案创新、沙箱拉起和软件生态等话题分享最新实践,共同探索云端智能体AI基础设施的演进路径。
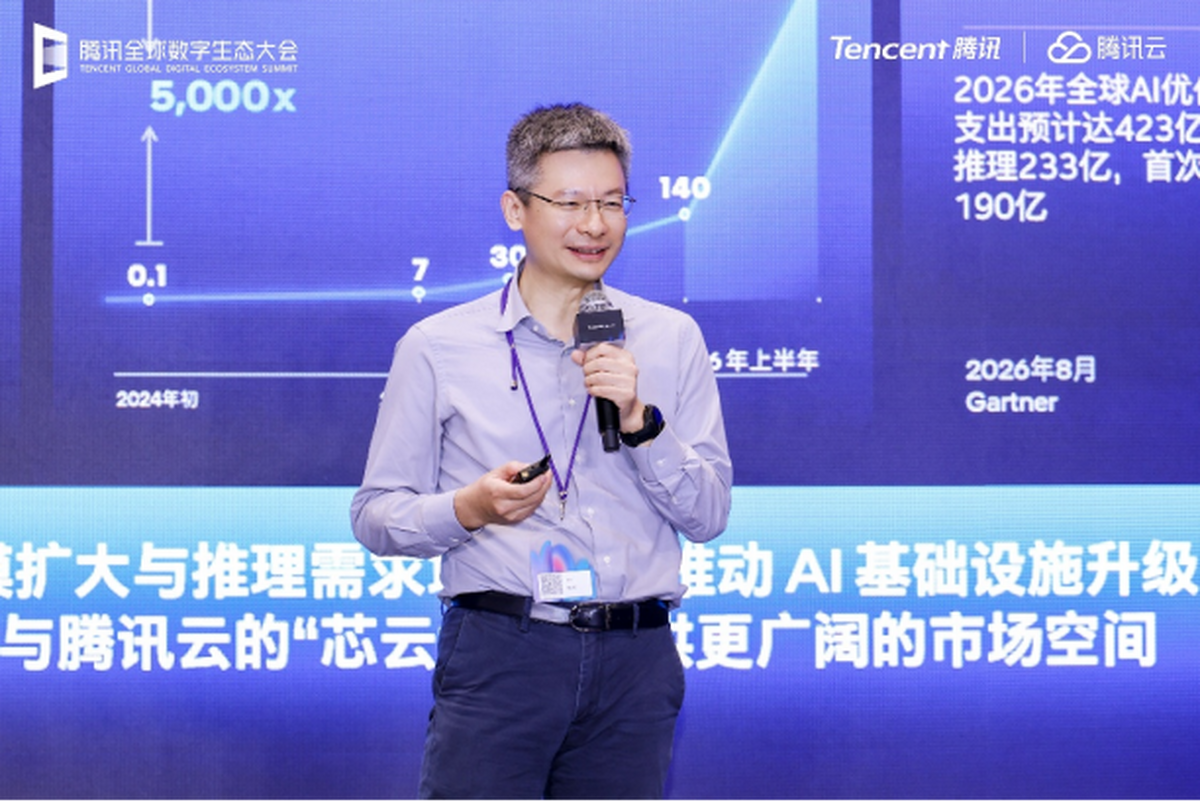
英特尔市场营销集团副总裁、中国区总经理郭威发表开场致辞
英特尔市场营销集团副总裁、中国区总经理郭威表示:“当AI从‘单次问答’加速迈向‘自主执行’,算力的价值也正从单点性能突破,走向云、端、模型与应用的全链路协同。从数据中心到智能终端,英特尔与腾讯持续拓展合作边界:以至强6/6+夯实云端算力底座,以智能体PC拓展端侧AI应用空间,通过模型与Agent深度协同优化释放全栈智能潜力,并依托开放生态汇聚更广泛的创新力量,共同贯通智能体AI从基础设施、模型到应用的关键链路。面向未来,英特尔期待与腾讯进一步深化‘芯、云、端’一体化协同,共建面向智能体AI的全栈算力底座,让算力各得其所,让智能触手可及,共同推动智能体AI从技术创新走向规模化应用。”
新一代云实例发布:英特尔至强6+处理器落地云端
英特尔与腾讯云的合作,始终紧跟云端工作负载的变化不断向前。从S9、S9e到S9pro,腾讯云基于英特尔至强6处理器,扩展云实例矩阵,以不同性能与成本组合,为多样化业务提供灵活、高效的弹性算力。如今,智能体AI的兴起,进一步考验着基础设施的并发调度、时延响应与可靠隔离能力。面对全新的智能体AI工作负载的要求,英特尔与腾讯云正式推出搭载英特尔至强6+处理器的新一代云实例,进一步扩展了腾讯云面向智能体AI工作负载的产品能力。

基于英特尔至强6+处理器的腾讯云新一代云实例正式发布
全新至强6+处理器为智能体AI提供了出色的计算资源。它拥有最高288颗能效核,单颗处理器最高可支持超过1000个智能体的稳定部署,这也为腾讯云服务器提供更高并发、更低时延、更优能效的云端算力服务。
在至强6+出色性能的支撑下,腾讯云新一代云实例综合性能较上一代提升30%以上,适配于云原生微服务、高并发Web与智能体任务编排等场景。值得一提的是,新一代云实例引入英特尔® TDX(信任域扩展),通过硬件级隔离与认证,为智能体构筑“数据可用不可见”的全生命周期可信防线。
这些实测数据,验证了英特尔至强6+处理器在智能体AI工作负载中的实际价值。但是,至强的演进并未止步于此。面向下一阶段更高密度的任务调度与并发计算,英特尔将推出专为下一代智能体AI基础设施设计的至强处理器(代号Diamond Rapids),实现多任务高负载的吞吐飞跃。
解决智能体AI真实需求:让智能体记得更多、响应更快、运行更稳
智能体AI要走向规模化,每一环节都要经得住高密度、高并发的考验。比如,有限的内存要承载更多任务,KV Cache要在不同层级间高效流动、压缩与调度,沙箱要安全且快速拉起,多模态数据还要被高效处理。面对这些贯穿计算、存储与执行链路的新要求,英特尔将至强处理器强大的计算能力、内置硬件加速和软件优化结合起来,与腾讯云共同打通智能体AI运行的关键链路。

腾讯全球数字生态大会英特尔展台
智能体AI越深入真实业务,内存就越显珍贵。高并发和持续运行不断推高内存需求,客户既希望用有限的内存承载更多任务,又不能以牺牲时延、拉高成本为代价。如何在高密度、高并发的业务场景下,同时满足对密度和时延的双重需求,这是软件方案解决不了的问题,也是腾讯云与英特尔推进内存应用创新的出发点。
借助英特尔至强处理器内置的英特尔® IAA(内存分析加速器),腾讯云对内存解决方案进行创新,为内存压缩和解压缩引入了硬件加速,满足客户对解压时延极度敏感、必须严格可控的要求。和软件方案相比,2M页的解压有了IAA加持后,解压时延被拉进微秒级,平均耗时加速16倍、最大耗时加速9倍,在提升内存利用率的同时,实现了更稳定、可预测的响应,让内存不再成为高密度、高并发智能体AI的性能瓶颈。目前,该方案已经过腾讯云验证并已完成业务上线。
智能体AI要高效运转,执行环境也要随叫随到。当智能体AI工作负载开始大规模落地,基础设施面临的另一项重要挑战,是如何在极短时间内批量创建并拉起海量沙箱,高效完成执行环境的编排与隔离。基于英特尔至强处理器与腾讯云CubeSandbox的深度协同,双方共同打造高并发、极速启动、稳定可靠的沙箱底座。
依托至强6+处理器强劲的计算性能、灵活的扩展能力与可靠的平台能力,CubeSandbox可高效支撑高密度沙箱负载,实现更低的启动时延和更高的资源利用效率。这为智能体应用的大规模沙箱化部署提供了坚实基础,在保障服务响应速度和性能一致性的同时,进一步提升沙箱并发创建能力,让每一个智能体应用都能即时响应、从容扩展。经腾讯实测,在满足200毫秒SLA要求的前提下,搭载至强6+处理器的CubeSandbox,单机可支持350个沙箱并发创建请求,较其他主流测试平台提升约46%。
执行环境要快速就绪,进入真实业务的智能体还要面对另一类挑战:比如快速批量处理具身智能数据等。智能体与现实世界的交互早已超越文本,视频、图像、音频等数据正在大量进入工作流,对数据处理和推理效率提出了更高要求。针对这一变化,腾讯云多模态计算引擎Xpark应用至强处理器内置AI加速引擎英特尔® AMX(高级矩阵扩展),将CPU资源用于小模型推理和轻量级多模态任务,进而提高AI计算吞吐与整体资源利用效率。这一优化所带来的提升,在Xpark视频处理工作流中体现得淋漓尽致:在iVTAL(英特尔视频转码加速库)的加持下,视频转码性能和开源PyAV相比提升了1.5倍4,整体视频处理效率显著提高。目前,Xpark已正式上线,应用于实际业务场景之中。
除了与腾讯云的上述联合创新之外,英特尔还介绍了基于至强处理器的智能体AI的存储平台。面向大容量、高性能、高能效、易部署的存储需求,英特尔通过高速I/O,QAT、DSA等内置加速器、UINTR+TPAUSE专用指令等软硬件协同优化,解决KV Cache的流转和复用效率等问题,让存储从放得下走向流得动和效率高。
构建系统级能力:加速智能体规模化落地
AI基础设施格局正在重塑,异构成为必然趋势。英特尔为客户打造了覆盖CPU、GPU、存储和网络的系统级方案,产品组合涵盖至强、以太网控制器和GPU D系列等。其中,英特尔® GPU D系列(代号Crescent Island)专为持续运行的内存密集型AI推理工作负载而打造:基于Xe3P架构,在350瓦功耗范围内,可为用户提供高达480 GB的LPDDR5X内存、1.5 TB/s内存带宽以及1.3 PFLOPS FP8算力,让大容量推理更易部署。
要让硬件性能真正转化为开发者的生产力,开放、易用的软件生态同样关键。英特尔坚持AI软件栈开源并优先贡献至上游社区,覆盖PyTorch、vLLM、SGLang等主流框架,以及Triton、oneDNN、oneCCL等计算与通信库,帮助主流模型实现开箱即用。此外,针对已有代码的跨平台迁移,英特尔引入基于大语言模型的AI Agent,结合专业Skill能力,在理解算法意图的基础上原生重构代码,并完成编译、验证与性能调优的全流程闭环,让跨架构迁移从“能跑”走向“跑好”。

腾讯全球数字生态大会英特尔展台
与此同时,英特尔将算力与智能体能力从云端延伸至终端、边缘。搭载WorkBuddy、Marvis的AI PC和基于英特尔®酷睿™ Ultra处理器的车载AI Box等端侧应用集中亮相,生动呈现了端云协同的端侧智能体验,让智能体AI走进千家万户。
依托覆盖算力、存力、软件优化等在内的系统级创新,英特尔正以至强为算力中枢,构建智能体AI时代的高性能智算底座。在智能体从技术探索走向全场景生产力的浪潮中,英特尔将继续以开放、包容的全栈平台能力,与广大生态伙伴并肩前行,共同拥抱智能时代的新机遇。
来源:天极网 The End
免责声明:本文内容来源于第三方或整理自互联网,本站仅提供展示,不拥有所有权,不代表本站观点立场,也不构成任何其他建议,对本文以及其中全部或者部分内容、文字的真实性、完整性、及时性不作任何保证或承诺,请读者仅作参考,并请自行核实相关内容,不承担相关法律责任。如发现本站文章、图片等内容有涉及版权/违法违规或其他不适合的内容, 请及时联系我们进行处理。
相关阅读
- Lexar雷克沙携手BLG推出高颜值联名限定礼盒,电竞魅力与存储科技完美结合
- 海信携全球最大116RGB-Mini LED炸场IFA 2025,三大技术掀显示风暴
- 抢滩赛道先机走出科创新路,布局AI+虚拟人驱动微美全息(WIMI.US)快速抢占市场新空间
- 好评如潮 华硕Z890/B860主板带你体验SE冒险游戏新作
- 冬至“冻”真格!走进家门口的苏宁服务站
- 标贝科技携智能客服语音交互方案亮相中国呼叫中心及企业通信大会并荣获年度编辑推荐奖
- 森海塞尔Digital 6000为英国流行唱将Anne
- 蚂蚁集团2024年经营稳健,持续分红回馈股东员工
- 618想换壁纸电视?TCL Art 7M不止于薄,旗舰画质打破“花瓶”魔咒
- 实力圈粉全球 希瑞2026 CES落幕:硬核技术+权威奖项,定义智能睡眠新高度
-
分类导航
-

-
最新文章
-
本栏文章
-
随机文章
-
友情链接
